ACROBAT
Cosa significa OCR: perché i software OCR sono importanti?
Scopri come l’OCR trasforma i documenti cartacei in file digitali.


ACROBAT
Scopri come l’OCR trasforma i documenti cartacei in file digitali.
Il riconoscimento ottico dei caratteri (OCR) è noto anche come riconoscimento del testo. Esiste da quasi 50 anni, ma con la crescente diffusione della tecnologia nella nostra vita professionale, è diventato sempre più centrale anche nella quotidianità.
La tecnologia ci ha permesso di portare con noi il lavoro e i progetti personali: dall’ufficio a casa, fino a qualsiasi angolo del mondo. La crescita tecnologica ha dato a un numero sempre maggiore di persone la possibilità di influire sul futuro. Nel mondo dei contenuti e della tecnologia, la parola d’ordine è “semplicità”. Gli strumenti OCR PDF sono ora disponibili gratuitamente e trasformano contenuti statici in file intelligenti e ricercabili.
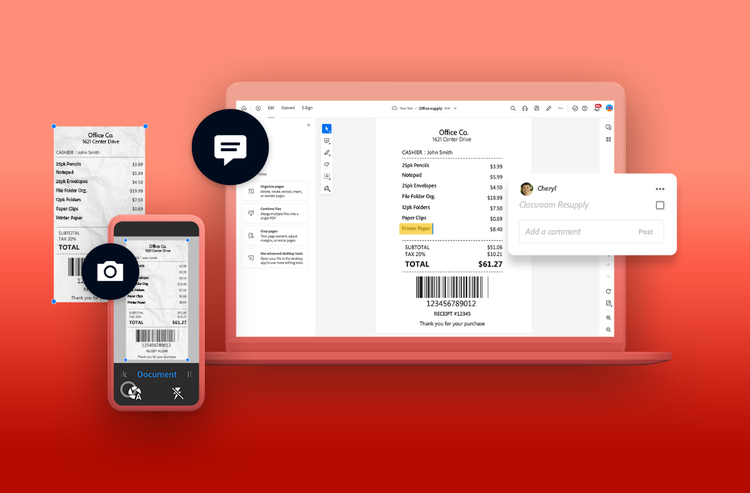
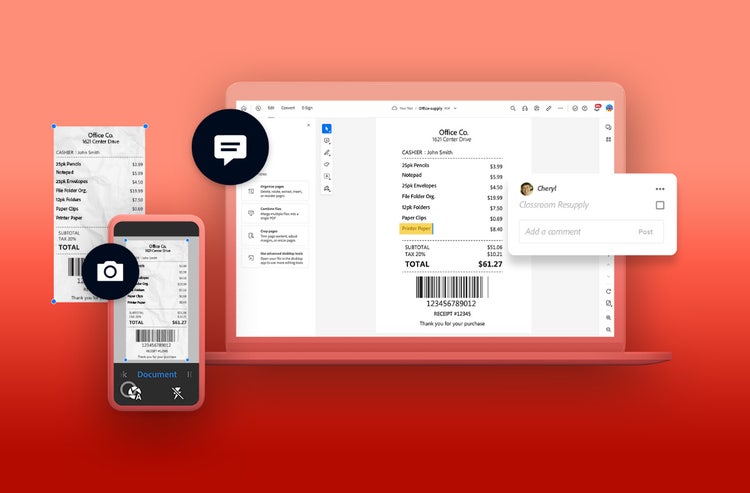
Il riconoscimento ottico dei caratteri (OCR) è una tecnologia che converte i documenti cartacei in file di immagine digitali. Funziona come una fotocopiatrice digitale che, grazie all’automazione, trasforma un documento scansionato in PDF leggibili da computer, pronti per essere modificati e condivisi. Un esempio pratico: quando si scansiona una ricevuta con il computer, questa viene salvata come immagine. Pur non essendo possibile eseguire ricerche, modificarla o contare le parole al suo interno, uno strumento OCR PDF consente di convertirla in un documento di testo, con il contenuto salvato come testo. I software OCR richiamano dati da immagini acquisite con la fotocamera, PDF solo immagine e documenti scansionati, rendendo i contenuti statici modificabili ed eliminando la necessità di inserire i dati manualmente.
Sebbene il mondo sia ormai in gran parte digitale, molte aziende continuano a fare affidamento sulla carta. Fatture, contratti, documenti legali scansionati e moduli cartacei sono ancora all’ordine del giorno. Gestire tutta questa carta richiede spazio fisico, tempo e risorse. Il passaggio al digitale è però sempre più diffuso. Digitalizzare i documenti tramite scansione può risultare lento e macchinoso, poiché richiede intervento manuale. Oggi esistono diversi strumenti OCR PDF gratuiti in grado di convertire le immagini in testo leggibile da altri software aziendali, facendo risparmiare tempo e denaro a persone e aziende. Questa tecnologia ottimizza i flussi di lavoro, supporta le analisi, automatizza i processi e aumenta la produttività complessiva.
L’OCR non si limita alla comodità di poter scansionare e ricercare testo: offre anche un accesso migliore alle persone non vedenti e ipovedenti. I software OCR tengono conto della lingua e della struttura del testo, correggendo automaticamente le parole con errori ortografici. Grazie alla tecnologia di controllo ortografico integrata, le informazioni trasmesse all’utenza risultano sempre precise. L’OCR include inoltre un sintetizzatore vocale che legge ad alta voce il testo riconosciuto. Tramite dispositivi di tecnologia assistiva, chi è non vedente o ipovedente può accedere al contenuto dei documenti scansionati: questi strumenti ingrandiscono lo schermo del computer, forniscono l’audio del testo o lo convertono in Braille. In questo modo, il software consente la lettura ad alta voce di qualsiasi documento scansionato, adattandosi alle esigenze di ogni persona.
Un motore o software OCR per PDF opera attraverso una serie di passaggi.
1. Analisi dell’immagine — uno scanner legge il documento e lo converte in dati binari. Il software OCR ispeziona quindi il file scansionato, classificando le aree chiare come sfondo e quelle scure come testo.
2. Pre-analisi — la tecnologia OCR ottimizza l’immagine attraverso diverse tecniche:
3. Riconoscimento del testo — la tecnologia elabora il testo tramite estrazione delle caratteristiche e corrispondenza dei pattern:
4. Post-elaborazione — Dopo l’analisi del contenuto, il sistema converte i dati di testo estratti in un file informatico. Alcuni strumenti OCR PDF gratuiti permettono di creare file con annotazioni che includono sia la versione originale che quella modificata di un documento acquisito. Se l’OCR non riconosce il testo, verifica che la scansione sia di alta qualità, ben illuminata e priva di distorsioni.
Questa tecnologia di trasformazione dei documenti fu sviluppata nel 1974 da Ray Kurzweil, fondatore di Kurzweil Computer Products, Inc. La novità consisteva nel riconoscere testo stampato in pressoché qualsiasi font. Kurzweil ritenne che l’applicazione più efficace della sua tecnologia fosse un dispositivo di machine learning per le persone non vedenti. Creò così una macchina di lettura in grado di leggere il testo ad alta voce e di tradurre il testo in formato sintesi vocale. Vendette la sua azienda a Xerox nel 1980, poiché quest’ultima era interessata a proseguire la commercializzazione della trasformazione di testo da carta a computer.
Questa tecnologia si è diffusa solo agli inizi degli anni ’90, quando veniva impiegata per digitalizzare i giornali storici. Da allora, l’OCR ha compiuto notevoli progressi. Oggi è in grado di offrire conversioni quasi perfette e i flussi di lavoro per l’elaborazione dei documenti possono essere automatizzati grazie a metodi avanzati. Prima che questo software fosse disponibile, i documenti dovevano essere ricopiati manualmente, con un dispendio notevole di tempo, energia e risorse, e con un rischio maggiore di errori nel contenuto. Oggi l’OCR è ampiamente accessibile e continua a incrementare l’efficienza sia in ambito personale che professionale.
I data scientist distinguono diversi tipi di software OCR in base all’applicazione e all’utilizzo. Ecco alcuni esempi:
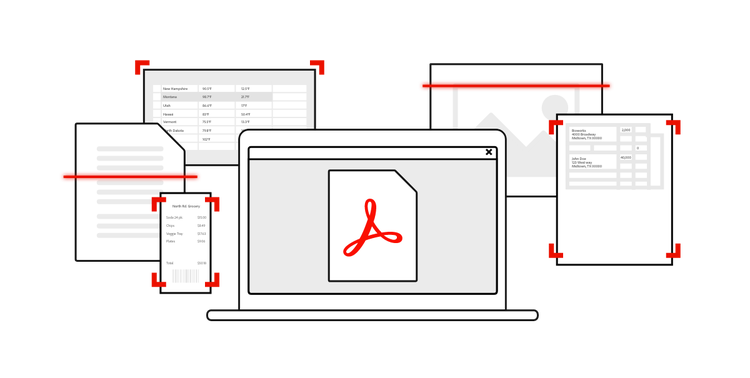
Di seguito sono riportati alcuni dei migliori strumenti PDF OCR per uso domestico e professionale.
Acrobat Pro mette a disposizione tutti gli strumenti OCR necessari per ottimizzare i flussi di lavoro e garantire efficienza nella gestione dei documenti. Con la versione Pro di Acrobat, oltre alle funzionalità OCR di base, puoi aggiungere commenti e feedback sui documenti, confrontare due documenti, utilizzare uno strumento dedicato alla scansione delle tabelle e molto altro ancora. I documenti acquisiti sono subito modificabili sullo schermo del computer, in pochi secondi. Le funzionalità OCR di Acrobat si integrano perfettamente con l’app gratuita Adobe Scan: puoi acquisire documenti e trasformarli in PDF. Il testo viene riconosciuto in modo automatico e, grazie agli strumenti OCR di Adobe, puoi apportare tutte le modifiche necessarie.
Questo software è rinomato per l’elevata precisione nelle conversioni. OmniPage Ultimate consente di creare flussi di lavoro personalizzati, così i documenti vengono recapitati in modo automatico nella posizione e nel formato giusti.
Abbyy FineReader mette a disposizione tutti gli strumenti PDF necessari per trasformare i documenti cartacei in digitali. Il software riconosce il testo e lo converte in PDF, nei vari formati Microsoft Office e in molti altri. È possibile confrontare documenti, aggiungere annotazioni, commenti e molto altro. Grazie all’elaborazione in batch, gestisce grandi volumi di documenti in un’unica operazione, supportando numerosi formati di output e 192 lingue diverse.
Readiris supporta un’ampia varietà di formati di file e consente di aggiungere firme e protezioni di sicurezza ai documenti, oltre a commenti, filigrane e annotazioni.
Questa soluzione OCR è stata progettata per analizzare le fatture ed estrarne le informazioni essenziali, da esportare nel programma in uso. Grazie all’IA, il software scansiona il documento e individua i dati rilevanti senza ricorrere a un modello predefinito, adattandosi così alle diverse strutture di presentazione delle informazioni che le fatture possono avere.
Uno degli usi più diffusi dell’OCR è la conversione di contenuti stampati in documenti di testo leggibili da computer. Tra gli altri casi d’uso figurano il supporto all’accesso ai contenuti per persone con disabilità visive, l’automazione dei dati e l’indicizzazione di documenti da parte dei motori di ricerca, come targhe, fatture, passaporti e altro ancora.
Esistono numerosi strumenti e software OCR pensati per soddisfare le diverse esigenze quotidiane, sia personali che professionali.
La creazione di documenti e la collaborazione sono elementi fondamentali per il funzionamento delle aziende, che con la loro crescita si trovano a gestire carichi di lavoro sempre maggiori. Sebbene si ricorra spesso all’inserimento di nuovo personale nel team, questa tecnologia consente di alleggerire il lavoro automatizzando alcune attività.
Eliminando l’inserimento manuale dei dati per determinate attività, è possibile concentrare le energie su compiti aziendali più strategici. Grazie all’estrazione e all’archiviazione automatica dei dati, le aziende migliorano i flussi di lavoro e l’efficienza operativa. I costi si riducono e i dati, in formato digitale, risultano più centralizzati e sicuri. Le aziende possono usare OCR per trasferire i dati in un foglio Excel e consultare i contenuti online in modo ordinato e immediato. Avere i contenuti online riduce il rischio di smarrimento o furto dei documenti e garantisce a tutti l’accesso alle informazioni più aggiornate, mantenendo così il team sempre allineato.
Il software OCR è uno strumento prezioso per supportare gli studenti e le studentesse nello studio. Ecco alcuni esempi di come può essere utile in ambito scolastico:
L’OCR è uno strumento efficace per studenti e studentesse con dislessia: basta scansionare un compito cartaceo per trasformarlo in un documento digitale, che può poi essere letto con il supporto di appositi strumenti.
Nel settore sanitario, l’OCR viene utilizzato per gestire le cartelle dei pazienti, inclusi referti di test, documentazione ospedaliera, trattamenti e Pagamenti assicurativi. Questa tecnologia ottimizza i flussi di lavoro e riduce il lavoro manuale. L’OCR semplifica la gestione delle cartelle e mantiene i contenuti sempre aggiornati, riducendo i tempi di inserimento dei dati nei registri elettronici e aumentando la precisione delle informazioni registrate, con meno margine di errore.
L’OCR facilita il recupero di informazioni dalle cartelle cliniche elettroniche (EHR, Electronic Health Record). Ad esempio, la storia clinica di un paziente archiviata in un EHR può essere recuperata in pochi istanti tramite una ricerca OCR, senza che il medico debba sfogliare manualmente i documenti. Le cartelle mediche cartacee possono essere scansionate e digitalizzate, così i professionisti sanitari accedono con facilità alle informazioni di cui hanno bisogno. La tecnologia consente inoltre di scansionare ricette e altri documenti importanti, riducendo il rischio di errori e garantendo la sicurezza dei pazienti. Grazie all’OCR, è possibile creare moduli digitali per risparmiare carta e tempo, rendendo la gestione dei documenti molto più agevole.
L’OCR e il machine learning hanno registrato una crescita esponenziale negli ultimi vent’anni e continueranno a evolversi nei prossimi. La nuova generazione di OCR è basata sul machine learning e sull’IA, superando i limiti di corrispondenza dei caratteri dei software precedenti. Che si tratti di strumenti OCR PDF gratuiti o di software avanzati basati sul riconoscimento ottico dei caratteri, questa tecnologia è sempre più autonoma nel pensare e nell’apprendere.
La tecnologia OCR non si limita a rilevare il testo acquisito tramite scansione: ne interpreta anche il significato, dando senso al contenuto. Il machine learning lascia spazio al deep learning, che continua a svilupparsi e a trasformare l’OCR. Le tecnologie di deep learning si basano su reti neurali che imitano il funzionamento del cervello umano, consentendo agli algoritmi di verificare l’accuratezza senza dipendere da schemi storici. Grazie al deep learning, la tecnologia non si limita a leggere il testo, ma ne coglie il significato in modo del tutto autonomo.
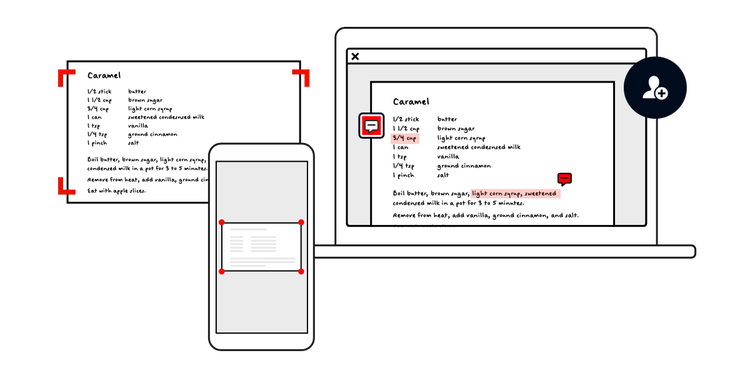
Le tecnologie e i software OCR permettono di ridurre il lavoro manuale, i tempi e i costi. Convertire documenti statici in documenti digitali, intelligenti e ricercabili aiuta le aziende a offrire un’esperienza migliore alla clientela e al personale, rendendo le informazioni più facili da trovare. Integrando le tecnologie OCR nel modello di business, puoi:
La tecnologia OCR aumenta la facilità d’uso e l’accessibilità, permettendo alle aziende di servire meglio la propria clientela e di alleggerire il carico di lavoro del personale.